Article publié le vendredi 20 novembre 2026 dans la catégorie business.
L’alignement mémoire consiste à placer une donnée à une adresse compatible avec sa taille et les attentes du matériel. Cette contrainte, souvent invisible dans le code courant, influe sur le nombre d’opérations nécessaires pour lire ou écrire une valeur. Elle compte particulièrement dans les boucles intensives, les tableaux volumineux, les structures fréquemment parcourues et les programmes vectorisés. Bien compris, ce mécanisme aide à améliorer les performances sans sacrifier inutilement la mémoire ni la portabilité.
L’alignement des données : définition et fonctionnement en mémoire
Adresses mémoire, tailles de mots et frontières d’alignement
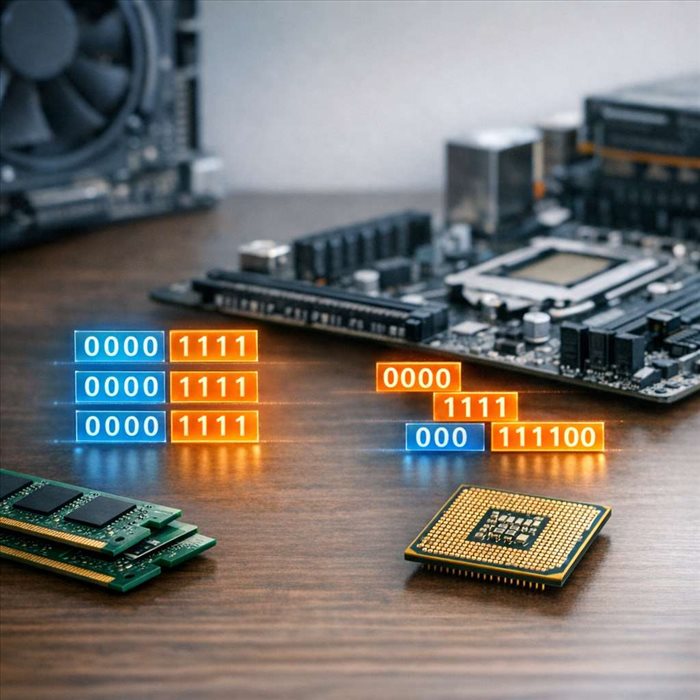
Une adresse mémoire identifie un octet. Une valeur de 4 octets, telle qu’un entier courant, peut en théorie commencer à presque n’importe quelle adresse ; pourtant, le processeur et le compilateur préfèrent souvent qu’elle commence à une adresse multiple de 4. C’est une
frontière d’alignement. Les valeurs usuelles sont 2, 4, 8, 16 octets ou davantage selon le type et les instructions utilisées.
L’exigence dépend de l’architecture, de l’ABI — l’interface binaire qui fixe notamment la disposition des types — et de la taille naturelle manipulée par le processeur. Sur une machine 64 bits, un pointeur ou un entier de 64 bits est généralement aligné sur 8 octets. Cela ne signifie pas que tout accès non aligné est impossible, mais qu’un accès aligné est le chemin prévu et souvent le plus simple pour le matériel.
La traduction entre adresses virtuelles et physiques est assurée par la MMU ; son fonctionnement est détaillé dans cet article sur
l’unité de gestion mémoire. L’alignement concerne donc la position des objets dans cet espace adressable, avant même les questions de cache ou de mémoire virtuelle.
Données alignées, non alignées et remplissage mémoire
Un accès est aligné lorsque son adresse de départ respecte l’exigence de la donnée. À l’inverse, une lecture de 8 octets débutant à une adresse qui n’est pas multiple de 8 est non alignée. Pour garantir les positions attendues, le compilateur ajoute parfois des octets inutilisés : le
padding, ou remplissage.
Par exemple, après un champ de type caractère, un compilateur peut insérer plusieurs octets avant un entier de 32 bits. La taille totale d’une structure inclut ce remplissage et est habituellement arrondie à l’alignement de son membre le plus contraignant. Cette disposition n’est pas arbitraire : elle permet que chaque élément d’un tableau de structures respecte lui aussi les contraintes de ses champs.
Pourquoi les processeurs accèdent plus efficacement aux données alignées
Réduire le nombre de lectures mémoire et de cycles processeur
Un processeur charge les données depuis les registres, les caches ou la mémoire selon une chaîne matérielle complexe. Le modèle
load-store d’un processeur repose précisément sur des instructions de chargement et d’écriture. Quand une valeur tient dans une unité d’accès appropriée, le matériel peut la récupérer et la transférer directement.
Une donnée mal positionnée peut chevaucher deux unités internes. Le processeur doit alors réaliser plusieurs lectures, recomposer la valeur et, lors d’une écriture, parfois lire puis modifier plusieurs portions. Le surcoût varie fortement : il peut être faible sur des processeurs x86 récents, mais devenir sensible dans une boucle chaude ou provoquer une exception d’alignement sur certaines configurations et instructions d’autres architectures.
Un accès non aligné n’est donc pas systématiquement lent, mais son coût est moins prévisible. Il dépend notamment de la taille de la donnée, de son emplacement et du processeur ciblé.
Éviter les accès fractionnés entre deux lignes de cache
Le cas le plus pénalisant apparaît lorsqu’une donnée chevauche deux lignes de cache. Une ligne est un bloc contigu transféré entre mémoire et cache, souvent de 64 octets sur les processeurs modernes. Une lecture de 8 octets placée à cheval sur deux lignes peut nécessiter la disponibilité des deux blocs, alors qu’une lecture voisine mais correctement positionnée n’en touche qu’un.
La hiérarchie décrite dans cet article sur les
différents niveaux de cache amplifie cette différence : un défaut dans L1, puis dans les niveaux suivants, est bien plus coûteux qu’une opération arithmétique. Le franchissement d’une page mémoire peut aussi être problématique, car deux traductions d’adresses et deux pages peuvent être sollicitées. Le rôle du
TLB dans l’architecture processeur devient alors pertinent.
Les effets de l’alignement sur les performances des programmes
Structures de données, padding et ordre des champs
Dans une structure, l’ordre des champs détermine le padding interne. Regrouper les membres du plus grand alignement vers le plus petit réduit souvent les trous. Une structure contenant un caractère, un entier 64 bits et un entier 32 bits peut ainsi occuper davantage d’espace que nécessaire si les champs sont déclarés dans un ordre défavorable.
| Disposition | Effet habituel |
| Petit champ avant un champ 64 bits | Padding potentiellement ajouté avant le champ large |
| Champs 64 bits, 32 bits, puis petits champs | Padding interne souvent réduit |
| Objet aligné sur une ligne de cache | Peut limiter le false sharing, mais augmente l’espace occupé |
Le
false sharing survient lorsque deux cœurs modifient des variables distinctes situées dans la même ligne de cache. Aligner ou espacer des compteurs indépendants peut réduire cette contention dans un code concurrent, sans accélérer pour autant les accès ordinaires.
Calcul vectoriel SIMD et exigences d’alignement
Le SIMD applique une instruction à plusieurs valeurs empaquetées dans un registre vectoriel. SSE utilise des registres de 128 bits, AVX de 256 bits et AVX-512 de 512 bits ; NEON, sur ARM, s’appuie couramment sur 128 bits. Les processeurs modernes acceptent souvent des chargements vectoriels non alignés, mais leur efficacité dépend du franchissement de lignes de cache et des instructions disponibles.
L’alignement est surtout utile lorsque les tableaux sont parcourus massivement et de manière régulière. Une allocation alignée peut garantir un début de tableau adapté, tandis que le compilateur peut exploiter cette information pour générer un code vectoriel plus favorable. En C et C++, `alignof` indique l’alignement requis d’un type et `alignas` permet d’imposer un alignement supérieur lorsque cela est justifié.
Les compromis : mémoire gaspillée, compatibilité et portabilité
Quand le padding augmente inutilement l’empreinte mémoire
Ajouter du padding améliore parfois les accès, mais augmente la taille des objets. Dans un tableau de millions de structures, quelques octets supplémentaires peuvent dégrader la localité et réduire le nombre d’éléments conservés en cache. Un alignement forcé de 64 octets pour de petits objets est rarement raisonnable hors d’un besoin précis de concurrence.
- Réduire le padding lorsque les structures sont nombreuses et peu partagées entre cœurs.
- Isoler sur une ligne de cache seulement les données fréquemment modifiées par plusieurs threads.
- Préserver l’alignement naturel des types plutôt que recourir aux structures compactées.
Les directives de type « packed » suppriment des trous, mais peuvent produire des accès non alignés. Elles sont appropriées pour des formats binaires ou des protocoles, pas comme optimisation générale de structures internes.
Différences entre architectures, compilateurs et langages
x86 tolère généralement les accès non alignés, avec un coût surtout visible aux frontières de cache ou de page. ARM peut également les gérer, mais les règles varient selon la génération, le type d’instruction et la configuration. Certaines architectures déclenchent plus facilement une faute d’alignement.
Les compilateurs respectent l’ABI de la plateforme : changer l’ordre des champs ou imposer un alignement modifie potentiellement la taille et la compatibilité binaire d’une structure. Les langages gérés masquent largement ces détails, sans les abolir dans les bibliothèques natives, les buffers ou les extensions vectorielles.
Il ne faut jamais supposer qu’une disposition mémoire est identique sur toutes les cibles.
Bonnes pratiques pour aligner les données sans optimiser à l’aveugle
Réorganiser les champs selon leur taille
Commencer par observer la taille réelle des structures et leur alignement est plus utile que d’ajouter des contraintes globales. Regrouper les champs de 8 octets, puis ceux de 4, 2 et 1 octet constitue une règle simple, à vérifier plutôt qu’à appliquer mécaniquement. Les formats sérialisés, les API publiques et les structures partagées avec du code externe exigent davantage de prudence.
Mesurer les goulots d’étranglement avant toute optimisation
Le profilage doit guider toute intervention : temps passé dans les boucles, défauts de cache, trafic mémoire et contention entre cœurs sont plus révélateurs qu’une intuition. Tester des versions alignées et non alignées sur les architectures réellement visées permet d’évaluer le gain et son coût mémoire.
L’alignement est une optimisation de disposition : efficace lorsqu’il corrige un accès critique, inutile lorsqu’il masque un problème algorithmique ou de localité plus large.
Questions courantes
Un accès non aligné provoque-t-il toujours un ralentissement ?
Non. Sur de nombreux processeurs x86 récents, il est souvent traité correctement avec un surcoût limité. Il devient plus coûteux lorsqu’il traverse une ligne de cache, une page mémoire ou qu’il est répété dans une boucle très sollicitée.
Le contexte d’accès compte davantage que le seul décalage d’adresse.
Pourquoi la taille d’une structure est-elle parfois supérieure à la somme de ses champs ?
Le compilateur insère des octets de remplissage afin que chaque membre commence à une adresse convenable. Il peut aussi ajouter du remplissage final pour que chaque élément d’un tableau de structures reste correctement positionné. Cette taille dépend des types employés, de leur ordre et des conventions binaires de la plateforme.
Faut-il déclarer toutes les structures avec un alignement élevé ?
Non. Un alignement excessif augmente la mémoire consommée et peut diminuer le nombre d’objets conservés dans les caches. Il se justifie surtout pour des données vectorisées, des buffers spécialisés ou des variables partagées entre plusieurs cœurs.
L’alignement naturel est généralement le meilleur choix par défaut.
Les directives de structure compacte sont-elles une solution au padding ?
Elles réduisent ou suppriment les espaces insérés entre les champs, mais elles peuvent créer des lectures non alignées. Elles conviennent principalement aux formats de fichiers, paquets réseau et données imposées par un protocole. Pour des structures internes, leur usage peut dégrader les performances ou poser des problèmes de compatibilité selon l’architecture.
Comment vérifier l’alignement d’un type en C ou en C++ ?
L’opérateur
alignof indique l’exigence d’alignement d’un type. Le spécificateur alignas permet, lui, de demander un alignement précis pour une variable ou une structure. La taille peut être contrôlée avec sizeof, tandis que les outils de débogage et les profils mémoire aident à observer la disposition effective et son impact.
Chiffres clés de l’alignement mémoire
Les frontières les plus courantes sont de 2 octets, 4 octets et 8 octets, correspondant notamment aux tailles habituelles des entiers et pointeurs. Les opérations vectorielles utilisent des largeurs plus élevées : les registres SSE font 128 bits, AVX 256 bits et AVX-512 512 bits. Une ligne de cache mesure fréquemment 64 octets sur les processeurs actuels : une donnée qui la chevauche peut nécessiter l’accès à deux blocs. Enfin, une page de mémoire virtuelle fait souvent 4 Kio ; franchir sa frontière peut impliquer deux traductions d’adresses distinctes.
Le bon équilibre entre rapidité et sobriété mémoire
L’emplacement des objets influence surtout le coût des accès répétés, la circulation des lignes de cache et l’efficacité du calcul vectoriel. Respecter les contraintes naturelles des types évite des opérations fractionnées, tandis qu’un ordre de champs cohérent limite le remplissage inutile. Pour autant,
un alignement plus élevé n’est pas automatiquement meilleur : il peut accroître l’empreinte mémoire et dégrader la localité des données.
Les cas les plus utiles concernent les structures massives, les boucles de calcul intensif et les données partagées entre cœurs. Les différences entre plateformes imposent également de ne pas confondre comportement toléré et comportement optimal. La démarche la plus fiable reste de
mesurer avant de modifier, puis de privilégier les ajustements qui améliorent un goulot d’étranglement démontré, sans fragiliser la portabilité ni la lisibilité du code.