Article publié le vendredi 13 novembre 2026 dans la catégorie business.
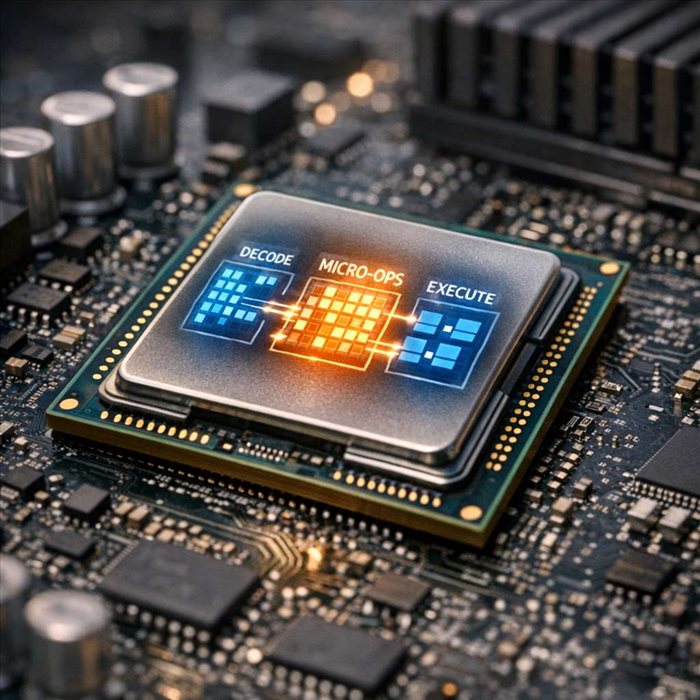
Une instruction x86 visible dans un programme n’est pas forcément l’unité réellement exécutée par le cœur du processeur. Les processeurs modernes traduisent souvent cette instruction en opérations internes plus simples, appelées micro-opérations ou µops. Cette séparation permet de conserver la compatibilité avec l’ISA x86 tout en exploitant un moteur d’exécution rapide, largement parallèle et capable de travailler hors ordre.
Définition : une micro-op, l’instruction interne du processeur
Une
micro-opération, souvent notée µop, est une opération interne élémentaire manipulée par la microarchitecture du processeur. Elle peut représenter, par exemple, une addition entre registres, un chargement depuis la mémoire, une écriture en mémoire ou un saut conditionnel.
Elle ne doit pas être confondue avec une instruction x86 architecturale. Cette dernière est celle que voit le compilateur, le programmeur ou le désassembleur : ADD, MOV, CMP, JMP, etc. Une seule instruction peut produire une µop, plusieurs µops, ou déclencher une séquence plus longue gérée par microcode.
Cette distinction relève de la différence entre
architecture et microarchitecture d’un processeur. L’ISA définit le comportement observable ; les µops sont un choix de conception interne, variable selon les générations et les fabricants.
Pourquoi les processeurs x86 décomposent les instructions en micro-ops
La complexité historique du jeu d’instructions x86
L’ISA x86 appartient historiquement à la famille CISC : elle propose des instructions de longueur variable, des préfixes, de nombreux modes d’adressage et des opérations parfois riches. Une instruction peut combiner calcul d’adresse, lecture mémoire, opération arithmétique et écriture du résultat.
Ce format est pratique pour la compatibilité et la densité du code, mais il est moins adapté à une exécution matérielle uniforme. Le rôle du
front-end est donc de récupérer les octets, prédire les branchements, identifier les instructions et les convertir. Pour approfondir cette phase, voir le
fonctionnement du décodage des instructions.
Une exécution interne plus régulière et parallélisable
Après traduction, le processeur peut traiter un ensemble plus homogène d’opérations internes. Le
back-end reçoit alors des µops adaptées aux ressources disponibles : unités entières, flottantes, SIMD, unités de branchement et unités de chargement/stockage.
Cette approche découple la complexité du langage machine x86 de l’organisation réelle du cœur. Elle facilite l’exécution simultanée de plusieurs µops indépendantes et limite l’impact d’une instruction x86 complexe sur le reste du pipeline. Le principe général s’inscrit dans le
pipeline d’un processeur, où plusieurs instructions se trouvent à des stades différents au même moment.
Du code machine aux unités d’exécution : le parcours d’une instruction
Décodage et génération des micro-ops
Le front-end lit le flux d’instructions, aidé par la prédiction de branchement qui estime la prochaine adresse à suivre. Les décodeurs x86 convertissent ensuite les instructions courantes en µops. Une instruction simple registre-registre peut être traduite directement ; une instruction plus élaborée peut en générer plusieurs.
De nombreux cœurs disposent aussi d’un
cache de µops. Il stocke des séquences déjà décodées : lors d’un passage ultérieur dans le même code, le processeur peut éviter une partie du travail de décodage, sous réserve que la séquence soit présente et exploitable.
Renommage des registres, planification et exécution hors ordre
Les µops entrent ensuite dans des structures internes, notamment le buffer de réordonnancement et le planificateur, aussi appelé station de réservation. Le renommage remplace les registres architecturaux, tels que RAX ou RBX, par des
registres physiques. Il élimine les fausses dépendances d’écriture après lecture (WAR) et d’écriture après écriture (WAW).
Une dépendance vraie, lecture après écriture (RAW), demeure : une µop consommatrice doit attendre la valeur produite par son prédécesseur. Dès que ses opérandes sont prêts et qu’une unité adéquate est libre, elle peut être lancée, même si des opérations plus anciennes sont encore en attente. C’est l’exécution hors ordre.
- Planificateur : conserve les µops prêtes ou en attente.
- Ports d’exécution : acheminent les µops vers les unités compatibles.
- Unités d’exécution : réalisent calculs, branchements et accès mémoire.
Retrait des résultats dans l’ordre du programme
L’exécution peut être spéculative, notamment après une prédiction de branchement, mais l’état visible du programme doit respecter les règles x86. Le buffer de réordonnancement, ou ROB, suit les µops en vol et assure leur
retrait en ordre.
Une µop terminée ne modifie donc pas immédiatement l’état architectural définitif si des instructions plus anciennes n’ont pas encore été validées. En cas de mauvaise prédiction ou d’exception, le processeur peut annuler les résultats spéculatifs concernés et restaurer un état cohérent.
Exemple concret : comment une instruction x86 devient plusieurs micro-ops
Considérons une instruction de forme « additionner une valeur mémoire à un registre », par exemple ADD RAX, [RBX]. Son comportement architectural est simple : lire la donnée à l’adresse contenue dans RBX, l’ajouter à RAX, puis écrire le résultat dans RAX.
En interne, elle peut correspondre à plusieurs travaux : calcul ou préparation de l’adresse, chargement depuis le cache ou la mémoire, puis addition entière. Selon le cœur, certaines de ces opérations peuvent être représentées par des µops distinctes ou partiellement combinées.
| Instruction visible | Travail interne typique |
| ADD RAX, RBX | Une opération arithmétique sur registres |
| ADD RAX, [RBX] | Accès mémoire et addition, parfois fusionnés |
| Instruction complexe | Séquence de µops, éventuellement pilotée par microcode |
Le
nombre de µops n’est pas une propriété universelle de l’instruction : il dépend des opérandes, du mode d’adressage et de la microarchitecture étudiée.
Micro-ops, microcode et instructions fusionnées : ne pas confondre
Les instructions simples et le microcode pour les cas complexes
Le microcode n’est pas le synonyme de µop. Il désigne un mécanisme interne permettant de piloter des séquences nécessaires à certaines instructions complexes, rares ou particulières. Une instruction microcodée peut générer ou orchestrer de nombreuses µops, alors qu’une instruction ordinaire est souvent traitée directement par les décodeurs.
Les mises à jour de microcode peuvent aussi corriger certains comportements matériels ou appliquer des mesures d’atténuation. Le rôle précis de ce mécanisme est détaillé dans cet article sur le
microcode d’un processeur.
La fusion de micro-ops chez les processeurs modernes
La fusion cherche à réduire la pression sur les files et les ressources internes. La fusion de macro-instructions peut, par exemple, associer une comparaison et un branchement conditionnel voisins. La fusion de µops peut réunir, dans certains cas, une opération mémoire et une opération arithmétique.
Ces mécanismes sont
propres à chaque microarchitecture. Ils ne modifient pas le résultat architectural du programme ; ils optimisent uniquement le chemin interne emprunté par les instructions.
Ce que les micro-ops changent pour les performances réelles
Débit, latence et limites des ports d’exécution
Deux métriques sont essentielles. La
latence est le nombre de cycles avant qu’un résultat puisse alimenter une µop dépendante. Le débit indique combien d’opérations une ressource peut accepter par cycle. Une addition peut avoir un bon débit, tout en imposant une latence sur une chaîne de calculs dépendants.
Les performances dépendent aussi des ports d’exécution. Plusieurs µops prêtes peuvent se concurrencer pour le même port, l’unité de multiplication, l’unité SIMD ou les ressources mémoire. Une boucle courte peut donc être limitée par le front-end, les dépendances, les accès cache ou un port saturé.
Pourquoi l’optimisation dépend de la microarchitecture exacte
Compter seulement les instructions x86 est insuffisant. Deux processeurs compatibles peuvent produire des nombres de µops différents, offrir des largeurs de décodage distinctes, disposer d’un cache de µops différent ou fusionner des opérations de façon inégale.
Pour analyser une routine, il faut donc considérer le processeur ciblé, les dépendances de données, les accès mémoire et les ressources d’exécution.
Les µops expliquent pourquoi un même code machine peut avoir des performances sensiblement différentes d’une génération x86 à une autre.
Chiffres clés pour situer les µops
- 1 à 15 octets : c’est la longueur autorisée d’une instruction x86. Cette variabilité complique le travail du front-end : avant de créer des µops, il doit repérer précisément les limites de chaque instruction dans un flux d’octets, y compris lorsqu’il contient des préfixes ou un adressage mémoire.
- 4 instructions par cycle : sur les cœurs Intel Skylake, les décodeurs classiques peuvent, dans des conditions favorables, convertir jusqu’à quatre instructions x86 par cycle. Cette limite concerne le décodage ; elle ne garantit ni que quatre instructions seront exécutées, ni qu’elles produiront toutes le même nombre de µops.
- 6 µops par cycle : le cache de µops des processeurs Intel Skylake peut alimenter le back-end à ce rythme maximal lorsque le code y est disponible. Il peut ainsi contourner une partie de la limite des décodeurs, mais les dépendances de données, les accès mémoire et les ports d’exécution restent susceptibles de limiter les performances.
- 224 entrées : le buffer de réordonnancement d’Intel Skylake peut suivre jusqu’à ce nombre de µops en vol. Cette fenêtre permet de chercher des opérations indépendantes à exécuter hors ordre, sans modifier l’obligation de retirer les résultats dans l’ordre du programme.
Questions courantes
Une µop est-elle la même chose qu’une instruction assembleur ?
Non. L’instruction assembleur correspond à une opération définie par l’ISA x86 et visible dans le programme ; la µop est une
opération interne choisie par le processeur pour l’exécuter. Une même instruction peut produire une ou plusieurs µops selon le cœur utilisé.
Les µops sont-elles identiques sur tous les processeurs x86 ?
Non. Intel et AMD, ainsi que différentes générations chez un même fabricant, peuvent découper une instruction de façons différentes. Le nombre de µops, leur fusion possible et les unités qui les exécutent dépendent de la
microarchitecture, pas seulement de l’instruction x86.
Pourquoi le nombre de µops intéresse-t-il les développeurs ?
Il aide à identifier un goulot d’étranglement potentiel dans les boucles très exécutées. Une séquence générant beaucoup de µops peut saturer le décodage, les files internes ou certains ports d’exécution. Cette donnée doit toutefois être analysée avec la latence, le débit et les accès mémoire.
Le cache de µops remplace-t-il le cache d’instructions ?
Non. Le cache d’instructions conserve des octets de code machine, tandis que le cache de µops conserve des opérations déjà décodées. Les deux peuvent être utilisés successivement : le second évite surtout de répéter le travail de décodage pour du code fréquemment parcouru.
Une mise à jour de microcode change-t-elle le programme compilé ?
Non. Le code binaire et l’ISA restent les mêmes pour le logiciel. Une mise à jour peut en revanche modifier certains comportements internes du processeur, notamment pour corriger un problème matériel ou appliquer une mesure de sécurité. Son effet sur les performances est
possible mais dépendant du cas.
Le bon niveau de lecture des performances
Une instruction écrite en assembleur ne décrit qu’une partie du travail accompli par un cœur moderne. Sa traduction interne, les dépendances entre résultats et les ressources disponibles déterminent souvent le rythme réel d’exécution. Les µops offrent ainsi une grille de lecture utile pour distinguer une limitation de décodage, de calcul, de mémoire ou de planification.
L’essentiel est de retenir que
l’ISA garantit le comportement, tandis que la microarchitecture organise son exécution. Le nombre de µops ne constitue donc pas, à lui seul, un verdict sur la vitesse d’un code. Pour analyser une boucle sensible aux performances, il faut l’interpréter avec la latence, le débit et le processeur ciblé. Cette approche permet de passer d’une vision des instructions à celle des
ressources réellement sollicitées.
Repères pour identifier la ressource interne en cause
| Profil de code | Ressource à examiner | Cause interne fréquente | Effet possible | Repère utile |
|---|
| Instructions longues ou riches en préfixes | Front-end | Décodage x86 plus exigeant | Alimentation insuffisante du back-end | Le nombre d’instructions seul est peu parlant |
| Petite boucle répétée | Cache de µops | Séquence déjà traduite ou non présente | Décodage évité ou sollicité à nouveau | Le code chaud est le plus concerné |
| Calculs en chaîne sur une même valeur | Unités d’exécution | Dépendances RAW successives | Attente du résultat précédent | La latence devient déterminante |
| Calculs indépendants nombreux | Ports d’exécution | Concurrence entre µops compatibles | Saturation d’un port ou d’une unité | Le débit devient déterminant |
| Chargements mémoire fréquents | Unités de chargement et caches | Donnée non immédiatement disponible | µops en attente et exécution retardée | La localisation des données compte autant que l’instruction |
| Branches conditionnelles imprévisibles | Prédiction et spéculation | Chemin d’exécution mal anticipé | Travail spéculatif annulé | Le flux de contrôle limite le pipeline |
| Instruction complexe ou inhabituelle | Microcode | Séquence interne spécialisée | Davantage de travail interne potentiel | Le comportement varie selon la microarchitecture |